Crear un avatar con IA: guía para video de marca
Por el equipo creativo de Virtalio, una agencia creativa con más de 15 años produciendo diseño, video y audio para pymes, marcas y agencias. Última revisión: octubre de 2026.
Crear un avatar con IA es generar un video en el que una persona habla con la voz y el texto que tú le pones, partiendo de una foto y de un audio. El modelo no actúa: sincroniza. La foto define la cara y el encuadre; el audio define el ritmo, la duración y dónde cierra la boca. Por eso el resultado se gana o se pierde antes de generar: en la foto base, en la locución, en cómo se cortó el guion y en los derechos de esa cara y esa voz. Este es el proceso completo, con los puntos donde se rompe.
Qué estás construyendo, y qué no
Tres cosas se confunden seguido bajo la misma palabra:
- Avatar. Una identidad que se repite: la misma cara y la misma voz en diez videos, en dos idiomas, en el onboarding y en el anuncio. Texto a voz con IA resuelve la mitad del problema, la voz; el avatar le pone cara.
- Imagen a video. Una toma. Tomas una foto y la animas unos segundos para un plano suelto. No hay continuidad entre piezas, así que sirve para B-roll y no para un vocero. El detalle está en qué necesita una foto para convertirse en video.
- Vocero real. Una persona grabada. Cuesta agenda, estudio y repeticiones, y sigue siendo la mejor opción cuando lo que se vende es la persona.
El avatar es un activo, no una pieza. Si lo tratas como una pieza suelta, lo generas una vez y sale regular. Si lo tratas como un activo, inviertes media hora en el retrato y en la locución, y después produces variantes en minutos durante todo el trimestre.
Las cuatro piezas del kit
Antes de generar, un avatar necesita cuatro archivos aprobados. Si falta uno, el video sale y no se puede publicar.
- Retrato base. Una sola foto, aprobada por la marca y por la persona. De ella depende todo lo demás.
- Locución. El audio final, mezclado y a nivel. En los modelos de avatar actuales el video dura lo que dura el audio: no hay forma de estirar la toma.
- Guion por bloques. El texto cortado en tramos que quepan en el límite de duración por generación.
- Hoja de derechos. Quién autorizó esa cara y esa voz, para qué medios, por cuánto tiempo y con qué posibilidad de retirarla.
El retrato base: el encuadre que pide el modelo
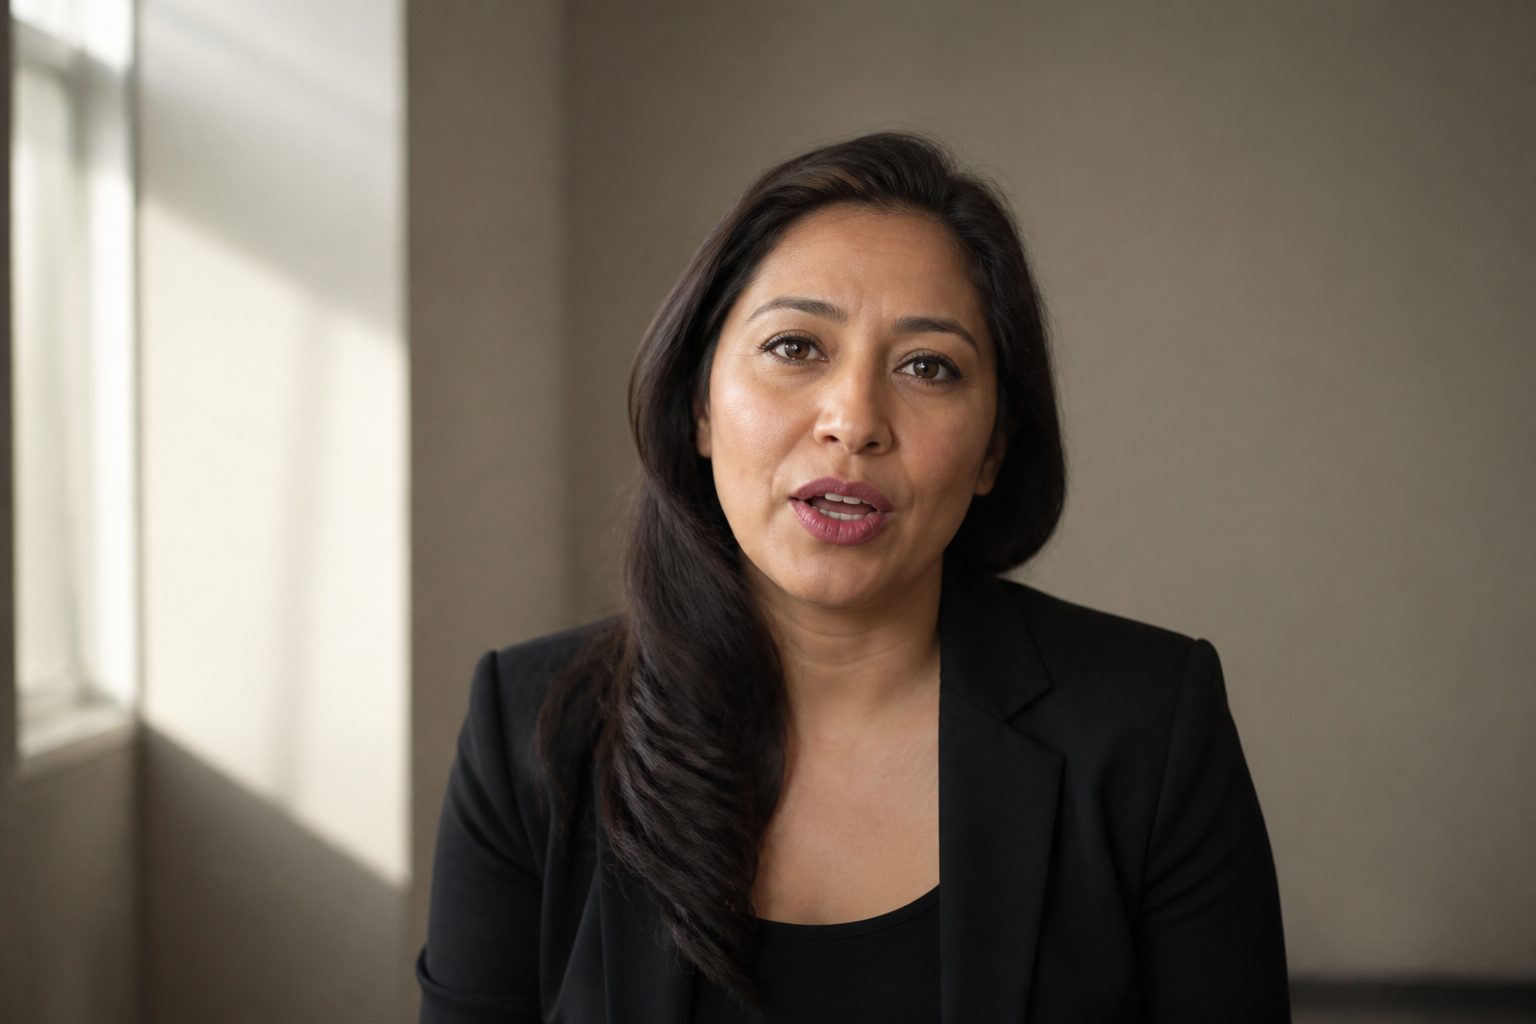
El modelo no ve a una persona: ve píxeles alrededor de una boca. Todo lo que tape, sombree o deforme esa zona produce un sincronizado flojo, y no hay texto de instrucción que lo arregle. Lo que pedimos en producción:
- Frontal o tres cuartos leve, ojos a cámara. Un perfil cerrado no funciona.
- Boca visible y relajada, sin dientes apretados, sin micrófono delante, sin manos, sin lentes oscuros.
- Luz suave y frontal. Una cara a contraluz deja la boca en sombra y el labio superior desaparece.
- Fondo limpio o desenfocado. El fondo también se mueve cuando la cabeza se mueve.
- Sin filtros de belleza fuertes ni retoque de piel agresivo. El modelo arrastra esa textura a todos los videos y se nota el plástico.
- Resolución suficiente para recortar a la relación de aspecto final sin ampliar.
- La misma foto durante todo el trimestre. Cambiar de retrato a mitad de campaña rompe la continuidad más de lo que parece.
Si el avatar es sintético, es decir, si nadie presta su cara, el retrato se puede generar con un modelo de imagen del mismo catálogo. Ganas libertad de encuadre y pierdes la prueba de que existe una persona detrás. Es una decisión de marca, no técnica.
La locución: lo que el modelo no arregla
El avatar hereda el audio tal como llega. Si la voz entra con ruido de sala, con dos tomas pegadas o con la respiración cortada, la boca lo refleja: el modelo abre y cierra donde el archivo se lo permite. La expresividad de la cara sale del audio, no de la instrucción de movimiento; esa instrucción sirve para indicar expresión general y movimiento de cámara, no para rescatar una lectura plana.
Tres reglas que ahorran regeneraciones:
- Graba o genera todos los bloques con el mismo micrófono, la misma sala y el mismo nivel. Un bloque que suena distinto delata el empalme aunque la cara sea idéntica.
- Deja respirar. Un locutor que no hace pausas produce un avatar que parece leer un teleprónter.
- Revisa la pronunciación de marca, cifras y nombres propios antes de generar. Corregir el audio cuesta un minuto; corregir tres bloques ya generados cuesta la tarde.
El límite de duración y cómo cortar el guion
El modelo de avatar disponible en el AI Studio acepta una imagen y un audio, y trabaja hasta 180 segundos por generación, en 480p o 768p. Esa cifra manda sobre el guion, no al revés.
Como referencia de trabajo, una locución de marca en español corre entre 130 y 160 palabras por minuto. Tres minutos dan entre 390 y 480 palabras: un texto de 700 palabras no cabe en una generación, y forzarlo produce un corte a mitad de frase que se oye.
Cómo se corta bien:
- En final de oración, nunca a mitad de una idea. Un bloque termina donde el locutor respiraría.
- Con 300 a 500 milisegundos de silencio al inicio y al final de cada audio. Sin ese margen, el modelo se come la primera consonante o cierra la boca antes de la última sílaba.
- Cada bloque como archivo distinto, con la misma foto y la misma semilla si el modelo la expone. Así la cara no cambia de un bloque al otro.
- Unión con corte seco y el mismo encuadre. Un cambio de plano entre bloques delata que son dos generaciones.
Para un video de 90 segundos, dos bloques de 45 funcionan mejor que uno de 90: si falla una frase, regeneras un bloque y no la pieza completa.
Revisión: el primer segundo decide
En un feed, el primer segundo del video es también la miniatura. Ahí se ve si el avatar funciona. La lista de revisión, en orden:
- Consonantes bilabiales. Busca una p, una b o una m. Si los labios no cierran, el resto del video tampoco va a convencer.
- Parpadeo. Un avatar que no parpadea, o que parpadea cada dos segundos, se lee como muñeco.
- Bordes. Pelo, orejas y cuello contra el fondo: ahí aparecen los halos y las deformaciones.
- Desfase en los extremos. Audio y boca suelen desalinearse en los últimos 300 milisegundos de cada bloque.
- Deriva del encuadre. Si la cabeza se desplaza dentro del plano a lo largo de un minuto, el corte con el bloque siguiente salta.
Revisa a velocidad normal y después a 0.5x en los primeros tres segundos. Si el primer segundo falla, se regenera el bloque. Publicar con la esperanza de que nadie lo note es la forma más rápida de que lo note todo el mundo.
Cuándo un avatar resta
Hay cuatro situaciones en las que un avatar con IA cuesta más credibilidad de la que ahorra:
- Testimonio. Un cliente hablando de su resultado es una prueba. Un avatar con la cara de ese cliente es la simulación de una prueba, y la audiencia lo detecta.
- Humor e ironía. Dependen de microgestos y de timing. El modelo sincroniza la boca; no interpreta.
- Marca personal. Si el activo es la persona, sustituirla por su avatar elimina justo lo que se estaba comprando.
- Demostración física. Un producto que se usa con las manos, un antes y después, una textura. Ahí la prueba es la pieza, no la cara.
En esos casos el avatar sirve para otra cosa: la versión en otro idioma, el recordatorio de una promoción, la explicación de tres líneas que no justifica convocar a nadie.
Derechos y transparencia
Un avatar reutilizable es un activo legal, además de creativo. Si la cara y la voz son de una persona real, necesitas autorización escrita con alcance definido: qué medios, qué territorios, por cuánto tiempo, si se puede usar en publicidad pagada y cómo se revoca. Un mensaje que dice «dale» no cubre una campaña de seis meses.
La transparencia dejó de ser una cortesía. El Artículo 50 del Reglamento europeo de IA obliga a quienes despliegan sistemas que generan o manipulan imagen, audio o video a declarar que el contenido que constituye un deepfake fue generado o manipulado artificialmente, y esa obligación aplica desde el 2 de agosto de 2026. Una marca que publica un vocero sintético para una audiencia europea tiene que decirlo de forma clara y perceptible, no esconderlo en un metadato.
La regla práctica que usamos: si el avatar dice algo que la persona no dijo, va etiqueta visible y va en el archivo de campaña. Si el avatar es un personaje declaradamente sintético, la etiqueta se integra al diseño en lugar de taparlo.
Cómo se produce en Virtalio
En el servicio de AI Studio el avatar entra como una pieza más del flujo: brief, retrato y locución aprobados, generación por bloques, revisión humana del primer segundo de cada bloque y entrega. La primera entrega de la mayoría de las piezas sale en menos de 48 horas; una campaña con varias variantes de avatar toma entre tres y cinco días, con revisiones incluidas y sin contrato.
Si el equipo quiere producirlo internamente, el AI Studio tiene el modelo de avatar junto al resto del catálogo de más de 150 modelos, y los planes incluyen créditos mensuales. Lo que no cambia en ninguno de los dos caminos es el orden: primero el retrato y la locución, después el guion por bloques, y la revisión antes de publicar.
Preguntas frecuentes
¿Cuánto puede hablar un avatar en un solo video?
Hasta 180 segundos por generación en el modelo de avatar del catálogo, en 480p o 768p. Un guion más largo se corta en bloques de 60 a 90 segundos, que además son más fáciles de corregir: si falla una frase, regeneras ese bloque y no el video completo.
¿Necesito una persona real para crear un avatar?
No. Puedes generar el retrato con un modelo de imagen y usar una voz sintética. Lo que sí necesitas, en cualquiera de los dos casos, es dejar por escrito qué se autorizó y qué no, porque un avatar sintético con rasgos reconocibles de una persona real sigue siendo un asunto de derechos.
¿El mismo avatar funciona en varios idiomas?
Sí, si la locución se graba o se genera en cada idioma: el audio es lo que mueve la boca, así que el idioma entra por el audio y no por la imagen. La revisión cambia, porque en un idioma que no hablas necesitas a alguien nativo escuchando la pronunciación de la marca y de las cifras antes de aprobar.
¿Un avatar reemplaza al vocero de la empresa?
Reemplaza la regrabación de una línea, no a la persona. Sirve para versiones, recordatorios y variantes de una campaña que ya existe. Cuando el mensaje es el posicionamiento de la marca o una disculpa pública, la cara real sigue siendo la única que se sostiene.
Fuentes
- Pruna AI. P-Video-Avatar, documentación del modelo. Entrada de una sola imagen más audio o guion de voz, y ajustes de resolución y semilla.
- WaveSpeedAI. P Video Avatar, ficha del modelo. La duración del video sigue al audio cargado; la instrucción de movimiento ajusta expresión y cámara.
- Unión Europea. Artículo 50 del Reglamento de IA. Obligación de declarar el contenido generado o manipulado que constituye un deepfake.
- Comisión Europea. Preguntas frecuentes sobre las obligaciones de transparencia del Artículo 50. Fecha de aplicación y definición de deepfake.